


月底对账,一家做客服机器人的小团队发现账不对劲。上个月的模型账单是 400 多块,这个月跳到 1300 多。
可调用次数只多了一成不到。老板先想到的是被多收了,把账单拍给技术,让他去问平台。
技术翻了两天的用量记录,找到了原因。这个月产品提了个需求:回答别那么干巴,多解释两句,再分成三段。
于是每条回答从一百多字变成了四百多字。次数没怎么变,字数翻了几倍,账单跟着上去了。
那个"按字数收费",到底是怎么算的?
一句话原理
大模型不认字,只认 token。你打出去的每个字,先被切成 token,模型按 token 的个数干活,也按 token 的个数收钱。
一个 token 大致是半个到一个汉字,或者三四个英文字母。所以收费的单位不是字数,是模型干活的那一份一份。
像手机流量。看视频费流量,发消息省流量,账按 G 算,不按你看了几个视频算。token 就是这个流量,只不过它分成两档:你发过去的,和模型回给你的。
如果只记一句:token 就是模型眼里的"字",它按这个字收钱。
一个具体例子
假设一次请求,你输入 2000 个字,模型输出 500 个字。
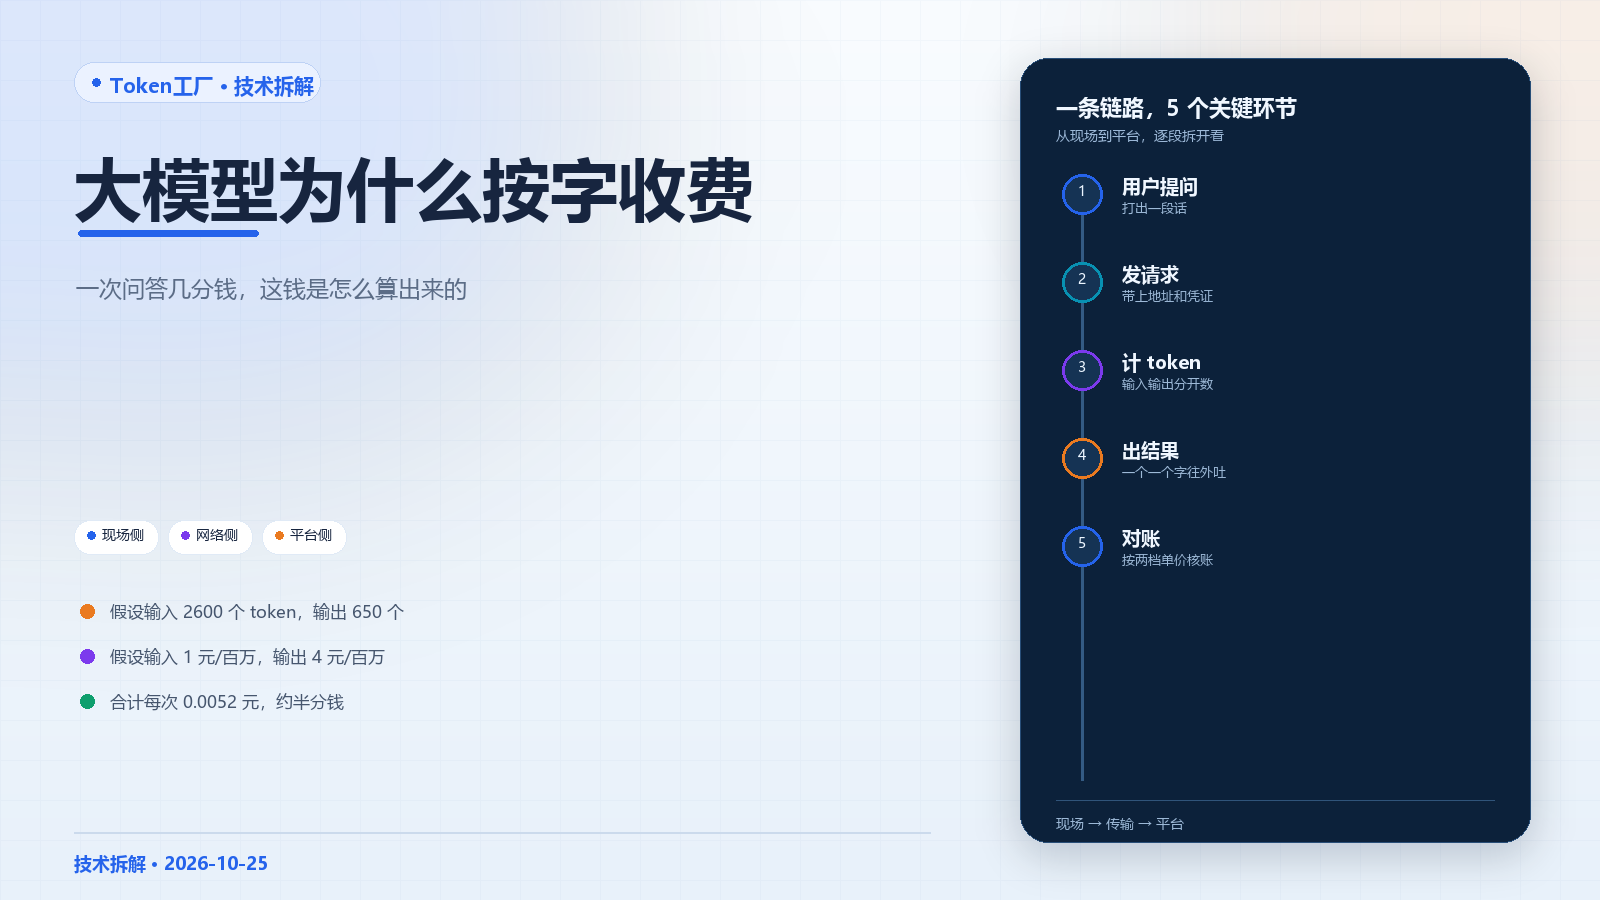
先看输入。2000 个字大概能切成 2600 个 token,各家切法不同,这里先按 2600 算。
再看价格。假设这家平台输入 1 元一百万 token,输出 4 元一百万 token。
输入这一份:2600 除以一百万,再乘 1,是 0.0026 元,也就是四分之一分钱。
输出贵四倍:500 个字大概 650 个 token,乘以四块,也是 0.0026 元。
一次问答合计 0.0052 元,半分钱。一个团队一天两千次,一个月六万次,三百块出头。
现在把回答从 500 字改到 1500 字。输入那 0.0026 元不动,输出变成 0.0078 元。一次从半分涨到一分,月账单从三百变六百。
要是再把提问从 2000 字堆到 6000 字,塞一堆参考资料进去,输入也变成 0.0078 元。一次一分半,月账单往九百走。
怎么证明?看平台后台的用量记录,输入和输出是分开列的。拿那段话再用分词器数一遍,两个数对得上,账就是对的。
一个小闭环
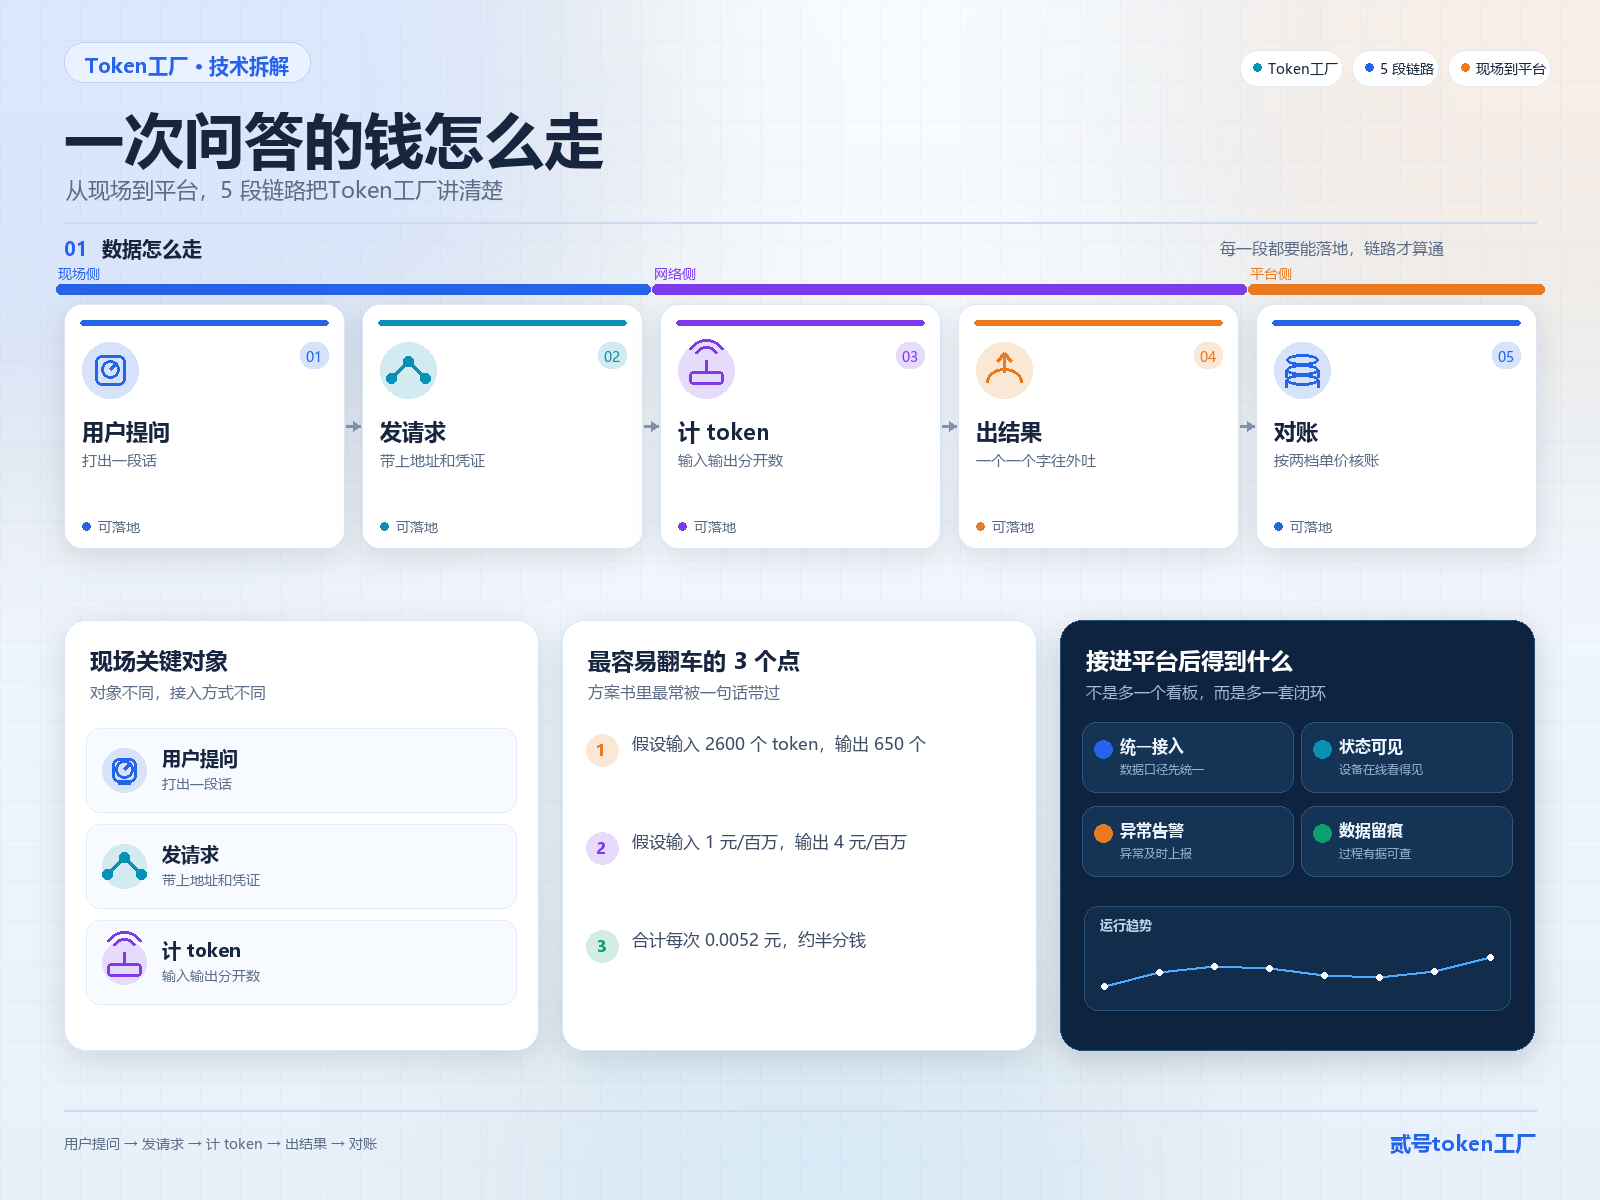
一,切词。输入是你打的那段话,动作用分词器切成 token,输出是一串编号。少了这步,模型拿到一堆字符,没法算。
二,发请求。输入是那串编号、base_url(接口地址)和 API key(调用凭证),动作是发出去,输出是服务端收下。少了这步,地址或凭证错一个字,请求根本到不了。
三,计 token。输入是请求内容和返回内容,动作是先把输入数清、再边生成边数输出,输出是一条用量记录。少了这步,账对不上,也说不清贵在哪。
四,出结果。输入是编号,动作是一个一个往外吐 token,再拼回文字。少了这步,你只看到用量,看不到答案。
五,对账。输入是平台用量和当月账单,动作是按单价核一遍,输出是这一次花了多少。少了这步,下个月还是不知道为什么涨。
三条技术确认点
一,确认输入和输出是不是两个价。多数平台输出比输入贵两三倍,还有一档缓存命中价,就是重复的开头被记住、按低价算。接之前把三档价格问全。
二,确认一个字算几个 token。中文的分词各家不同,同一个词,有的切一刀,有的切两刀。上线前拿自己的真实语料跑一百条,估出一次调用平均吃掉多少 token。
三,确认走中转时按谁的价算。地址换成中转的,计费也可能换一套,常见的是官方价乘一个倍率。先问清倍率和结算单位,别拿官方单价去对中转账单。
常见误区
看起来按字数收费,其实按 token。标点、空格、换行都算,一个表情符号能顶好几个。
看起来输入输出一个价,其实输出最贵。输入是一次算完的,输出得一个一个往外挤,每挤一个都要把模型跑一遍。
看起来问得多才花钱,其实问得长更花钱。上下文(这次对话里模型能看到的全部内容)越长,每一轮通常都要重读一遍,钱是按读了多少算的。
回到开头
那 1300 块的账单没被多收。是回答从一段变成三段,输出翻了倍,而输出恰好是最贵的那一档。
他们后来改了两处:提示词里写上"三句话内说完",参考资料从全部塞进去改成只挑相关的两段。账单回到五百以内。
token 就是模型眼里的字。调模型时真正花钱的,是进去了多少字,和出来多少字,尤其是出来的。
Token工厂:贰号token工厂
主流大模型 API token 统一接入、统一计费,改个地址就能用。
点这里看详情 →