


上周有个做运营的姑娘来找我。她要把官网上的三个「立即咨询」改成「预约演示」,自己动手改了两个小时。
她的做法是:打开网页版 ChatGPT,把页面代码整段复制进去,说改一下。对面很快给回一段代码,她再整段贴回文件。刷新一看,一个地方变了,另外两个还是老样子。
她不知道这三个按钮写在三个文件里,她只贴了其中一个。于是又贴第二遍、第三遍,改到第三轮时,她已经不记得自己动过哪几行了。
后来我让她在项目目录里说了一句话。工具自己去翻文件,改完把动过的几行列出来。同一句话,前面那份要她自己搬运,后面这份直接把文件改好了。
一句话原理
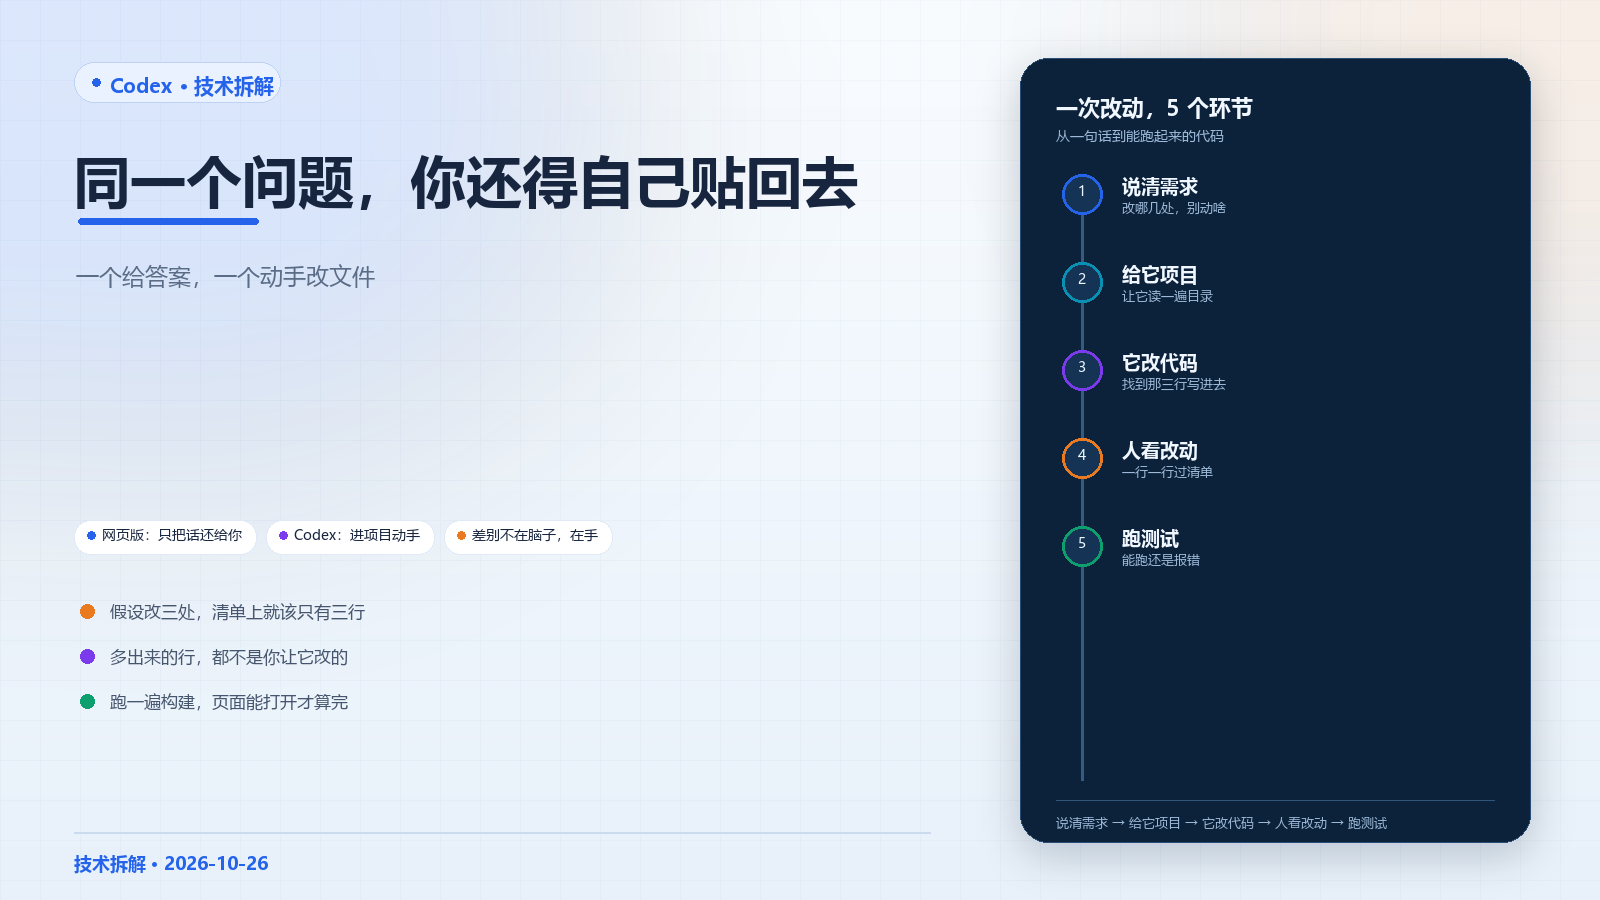
网页版 ChatGPT 是「你把东西递进去,它把答案递出来」;Codex 是「你把整个项目交给它,它自己找、自己改,再把改了什么列给你看」。
差别不在谁更聪明,在交付的东西不一样。一个交给你一段话,一个交给你改好的文件。
像隔着窗口办事,和把钥匙给人。隔着窗口,材料少一张就得回去取,取回来重新排队;给了钥匙,他自己进去找,但出来时你得清点他动了什么。
一个具体例子
假设一个两百行的页面,按钮文字出现在三个文件里,一共三行。这是假设,不是实测。
用网页版,你得先自己找齐这三处,一处一处贴进去,再一处一处贴回来。一轮大概六分钟,三处就是三轮。改完之后,你手上没有一份「我到底动了哪几行」的东西。
用 Codex,你只说一句:把三个「立即咨询」都改成「预约演示」,别动样式。它做四件事。读一遍目录,认出哪几个文件里有这句话,把那三行改掉,再把改动列出来。
这份清单在这类工具里叫 diff,就是一行一行标出「原来是什么、现在是什么」。你不用读全部代码,只看这几行。
怎么证明改对了?看三点。清单里正好三行,都是文字,没有颜色也没有间距。没有出现你没提过的文件。跑一遍构建,页面还能打开。
假设它顺手把按钮的宽度也调了,清单里就会多一行。那一行就是你要拦下来的地方。
一个小闭环
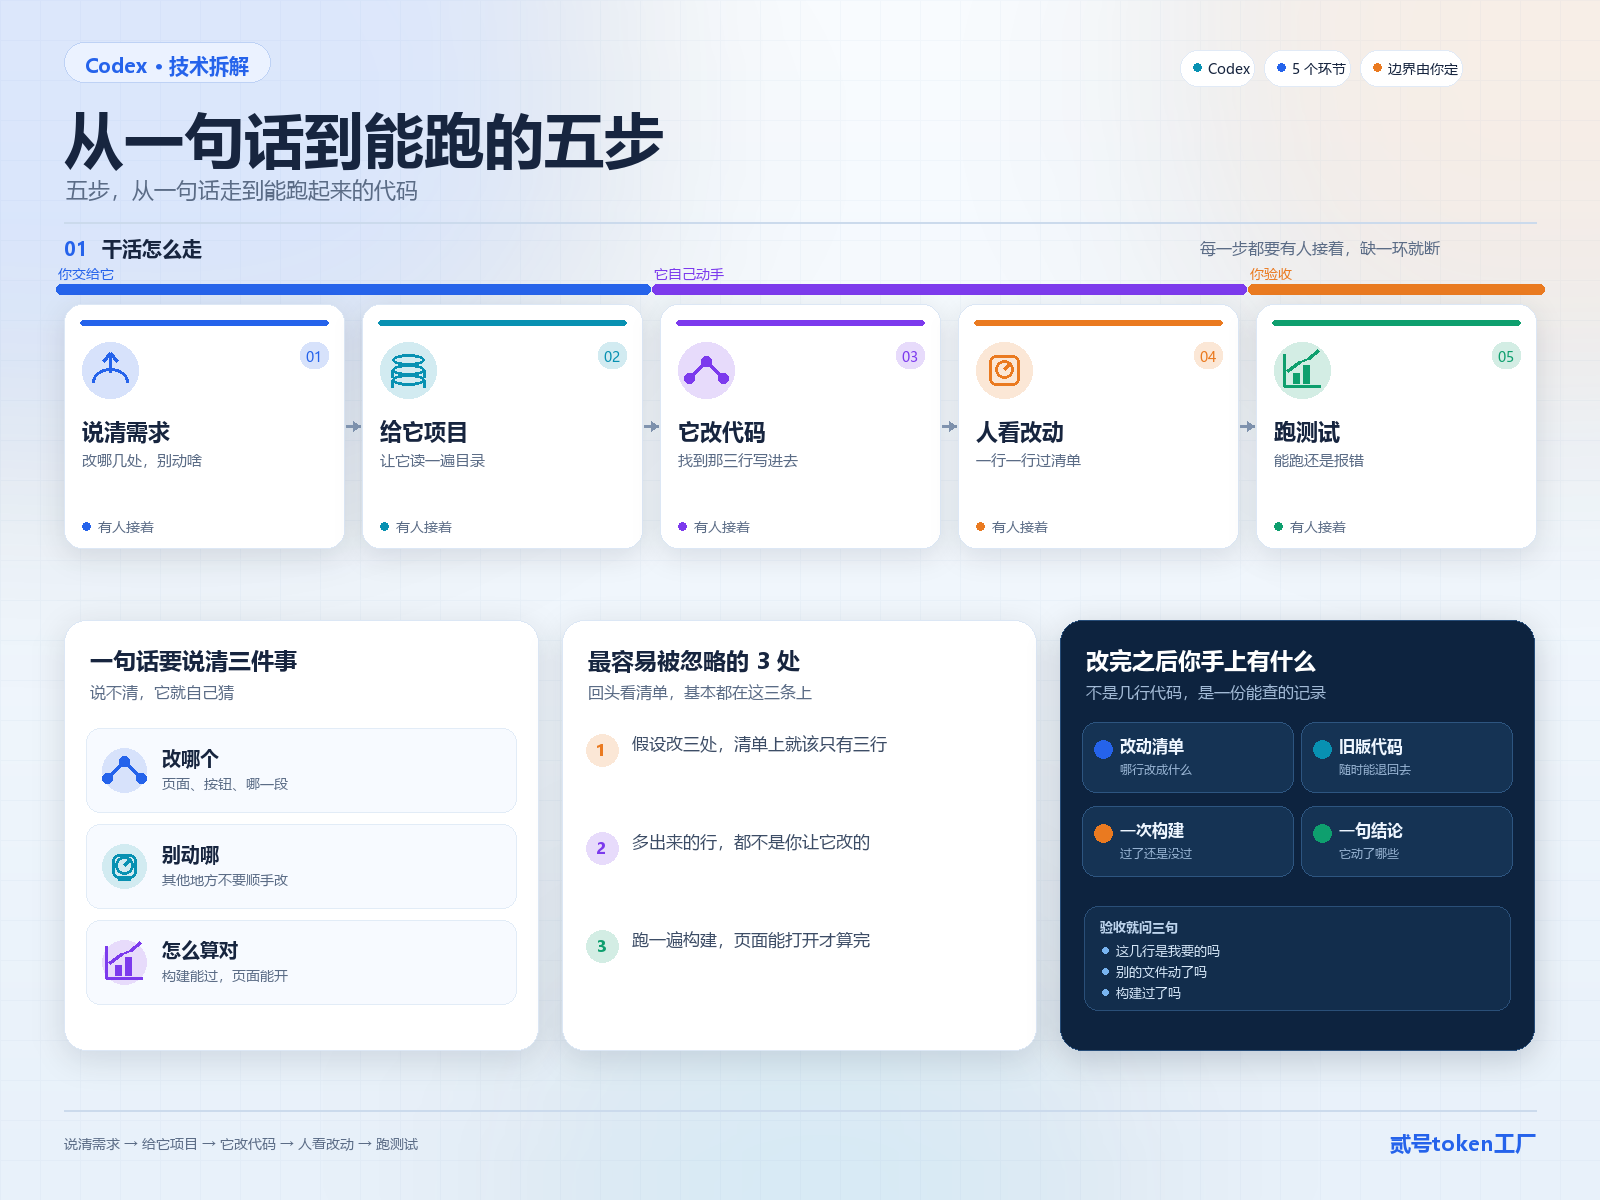
一,说清需求。输入是一句话,动作是把改哪里、动几处、别碰什么说死。输出是一条没有歧义的指令。少了这步,它会按自己的理解顺手优化,改出一堆你没提过的东西。
二,给它项目。输入是项目文件夹,动作是让它读一遍目录。输出是它知道哪几个文件跟这句话有关。少了这步,它又退回去靠你贴的那一段猜。
三,它改代码。输入是需求加项目内容,动作是找到那几行写进去,输出是一份改动清单。少了这步,你拿到的还是一段要自己贴回去的代码。
四,人看改动。输入是清单,动作是一行一行过,输出是留下或者撤回。少了这步,改错的地方会跟着一起上线。
五,跑测试。输入是改完的代码,动作是让它跑一遍构建,输出是通过或者报错。少了这步,你只知道它写完了,不知道还能不能用。
跑完再回到一。报错信息本身就是一句新的需求。
三条技术确认点
一,确认手上这个入口能不能执行命令。终端(那个黑底打命令的窗口)里跑的那个,能自己跑测试;编辑器里的那个,改完要你点一下确认。先弄清这一点,再决定让它干到哪一步。
二,确认它能碰哪些文件夹。它默认只在打开的项目里活动,越界会来问你一句,这就是老弹提示的原因。权限就是能不能读你的文件、写你的文件、执行命令,别为了省事一路点同意。
三,确认项目里有没有 AGENTS.md。这是一份放在根目录的说明书,写明用什么命令跑测试、代码放哪个目录、哪些文件别动。有它,进门就知道规矩;没有,每次都要从头试。
常见误区
看起来 Codex 比网页版聪明,其实用的是同一类模型。强的地方是它看得见整个项目,还能动手。
看起来省掉复制粘贴就等于省时间,其实多了一步看改动。这一步省不掉,省了等于把风险往后推。
看起来网页版可以不用了,其实问思路、看一段报错为什么出现,它还是快。它不动你的文件,也就不会改错。
回到开头
那位运营改完说:我那两小时,一半在搬运,一半在找自己改过哪儿。
网页版给你答案,Codex 给你改好的文件。你要的东西没变,多出来的是验收:看清单、看有没有多改、看还能不能跑。
一句话记住:它替你做搬运,你做验收。搬运能省,验收不能省。
Token工厂:贰号token工厂
Codex 要用的模型 token,统一接入、统一计费,改个地址就能用。
点这里看详情 →