


上周三晚上,我给一个导出功能加三个筛选条件。前两轮挺顺:它记住了我要按日期筛,也记住金额要留两位小数。
聊到第八轮,我让它把结果导成表格。表导得很干净,但日期那一栏又变回了带时间的写法,后面跟着 00:00:00。那个时间是我第三轮就让它去掉的。
我往上翻聊天记录,一条一条指给它看。它回了句抱歉,然后改对了。
可下一轮它照样又写回来了。那天我在一件说过三遍的小事上,多花了四十分钟。
一句话原理
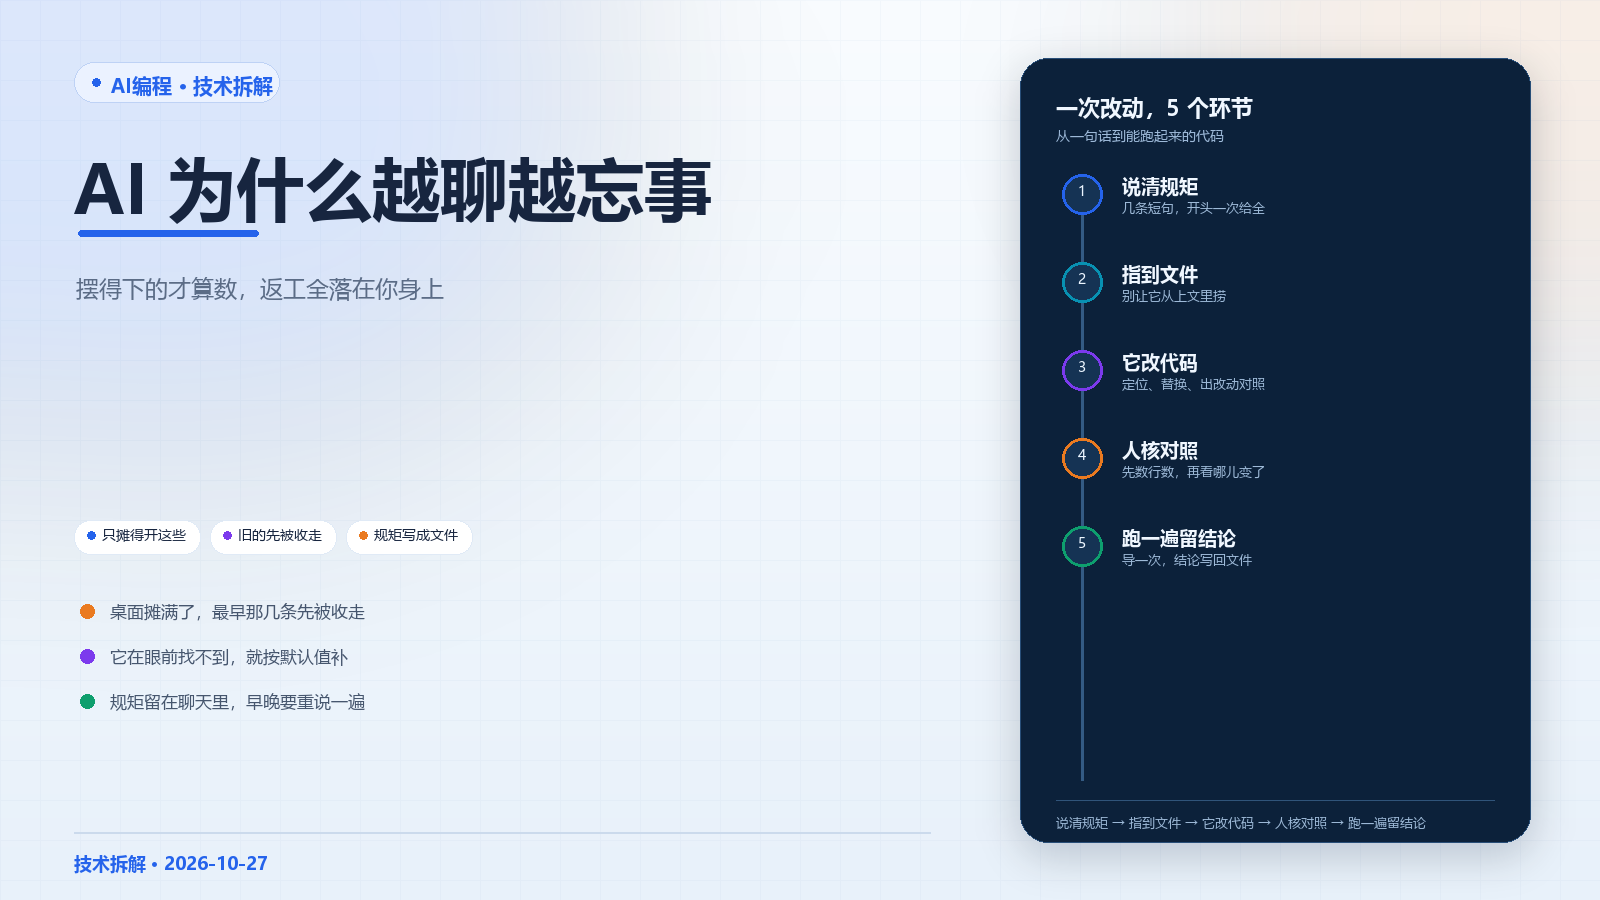
上下文,就是它这一次动手时,能同时摆在眼前的那些内容。摆得下的才算数,摆不下的等于没说。
它看不见自己的聊天记录像人一样往回翻。它每答一次,只看一遍当前摆在眼前的东西。
打个比方:桌面就这么大,摊开的是这一轮要用的资料。摊满了还要递新的,它得先把旧的收走。收哪几张、按什么顺序收,它不问你。
算个账。假设它一次能摊 20 万字,你聊十轮,每轮三四千字,桌面就满了。前面那几轮被收走,你不光白说,还得重说一遍。重说一遍十分钟,一天碰三回,半小时就没了。
一个具体例子
假设一个 200 行的文件,只改其中 3 行,就是把日期那栏的时间去掉。
人说的:导出时日期只留到天,不要后面的时间。
工具看到的:这一轮摆在它眼前的,是导出那段代码,加上最近几轮的话。你第三轮那句"只留到天",如果已经被收走,它眼前就只剩一段没写格式的日期字段。
它改的:按眼前能看到的写法补上默认值。默认值里带着 00:00:00,于是时间又回来了。它不是改错了位置,是照着一个不完整的规矩在改。
怎么证明改对了:先看 diff。diff 是改动对照,删了哪行、加了哪行,一行行列出来。数一下是不是只有 3 行变了。再把导出的第一行打开,看日期后面有没有多出时间。
两分钟能查完。跳过这步,下一轮它还会再犯一次。
一个小闭环
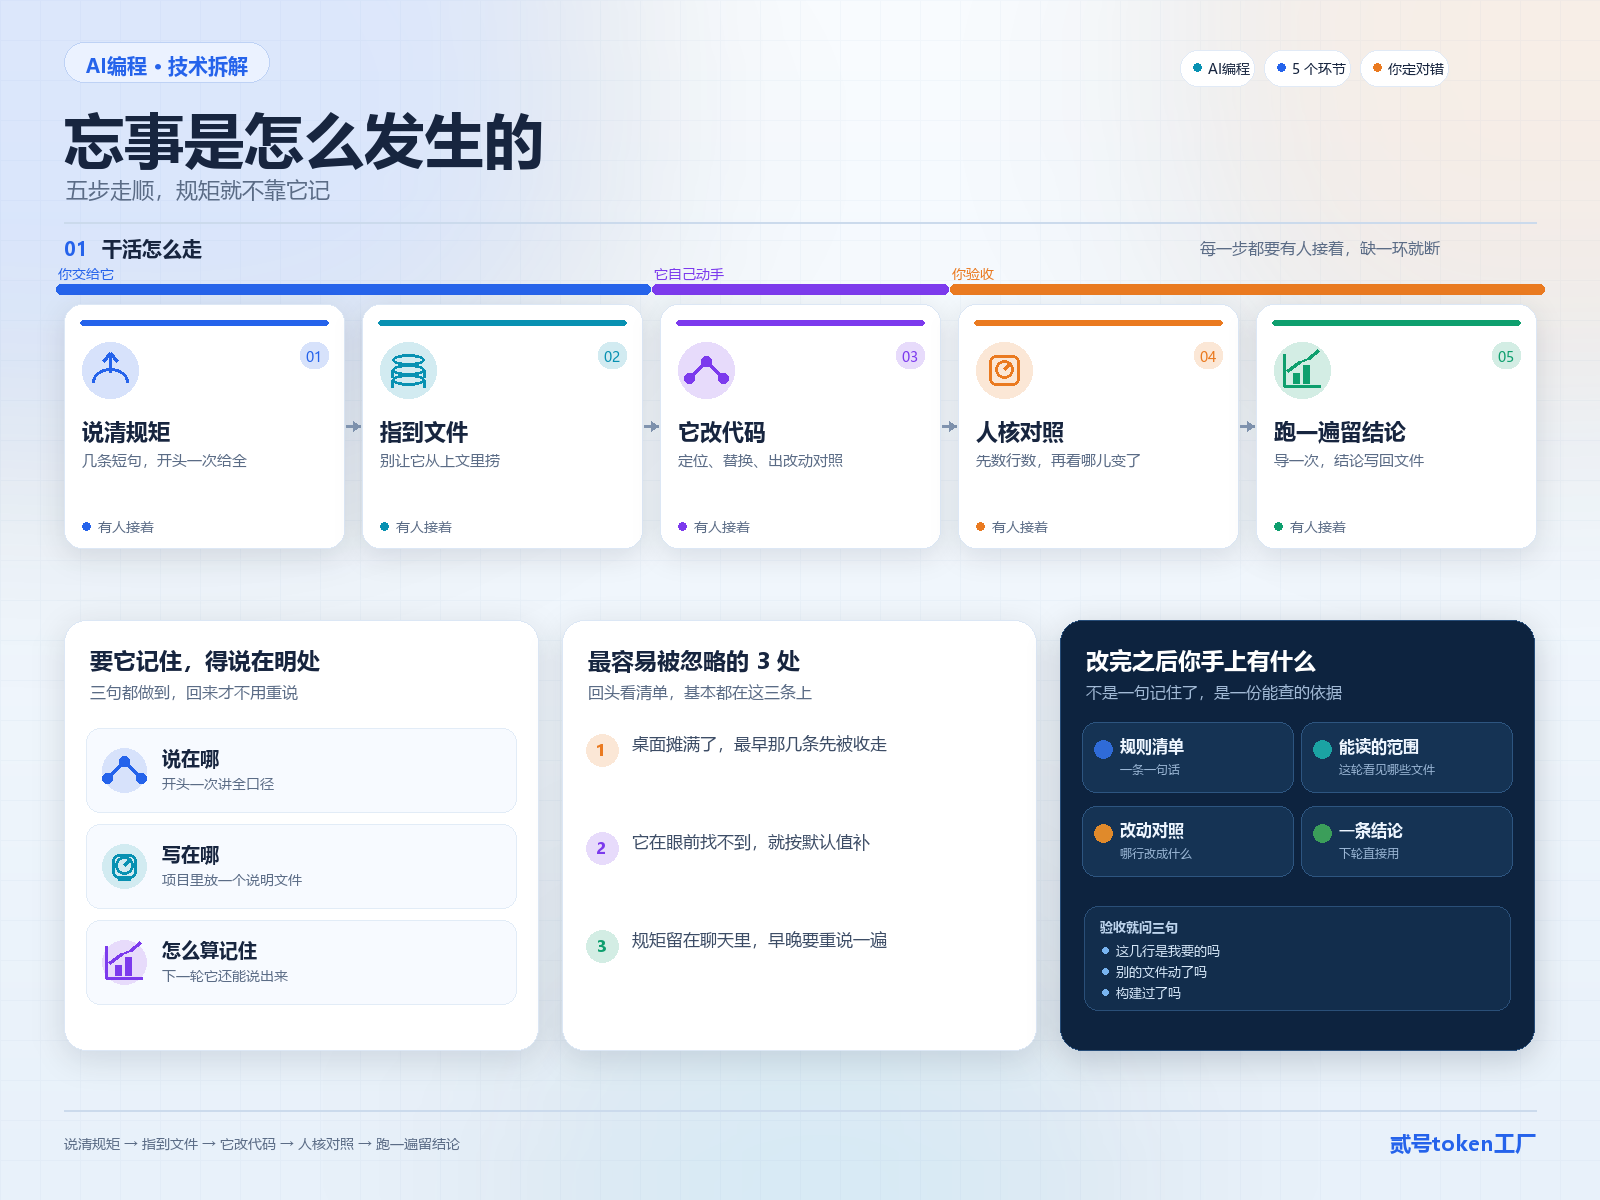
这五步走顺了,忘事带来的返工会明显少。缺哪一步,活就退回你身上。
- 一次说清规矩。输入是你脑子里的口径。动作是把它们压成几条短句,开头一次给全。输出是一份能照着验收的清单。少了这步,后面每一轮都要赌它还记得。
- 把资料指到位。输入是项目目录。动作是直接指给它要读的文件,别指望它从上文里捞。输出是这一轮它真正能读到的范围。少了这步,它只能靠记忆里的碎片拼。
- 它改代码。输入是规矩加资料。动作是定位、替换,生成改动对照。输出是一份能看的
diff。少了这步,就只剩聊天,代码还得你自己搬。 - 人核对照。输入是
diff。动作是先数文件数,再看那 3 行,最后看有没有顺手动别处。输出是一句"可以"或者"退回"。少了这步,写回来的旧格式会跟着一起上线。 - 跑一遍,把结论留下。输入是改完的代码。动作是导一次、看一眼日期,然后把这条结论写进项目里一个固定的说明文件。输出是下一轮还能读到的依据。少了这步,下一轮又从零开始谈。
三条技术确认点
上手前,先确认三件事。
- 一次能装多少。问清它一轮能读进多少字,这个上限叫上下文窗口。它决定你一轮能说几条规矩、能指几个文件。
- 装满了怎么处理。是默默把最早的丢掉,还是给你一句提示。默默丢的那种,你得自己把关键规矩挪到聊天之外。
- 规矩能不能落到文件里。能写进项目里一个说明文件的,每轮都读得到;只能留在聊天里的,早晚被收走。
常见误区
看起来是"它理解能力不行",其实是"那条规矩已经不在它眼前了"。
看起来是"聊得越久它越懂我",其实是"聊得越久,桌上换过的纸越多,最早那几条最容易先被收走"。
看起来是"我把话说重一点它就记住了",其实是"语气不占地方,规矩才占地方"。
回到开头
回到导出那一栏多出来的时间。
它没变笨,也不是跟我较劲。第三轮那句"只留到天",到第八轮已经不在它眼前了。
后来我改了做法:把三条口径写进项目里一个说明文件,每轮开头让它先读那个文件。同样的活,从四十分钟压到十分钟。
上下文不是记性,是位置。摆在眼前的才叫约定,收走了的都算没说。
Codex、Claude Code、Trae、Qoder 这类工具都吃这一条。
Token工厂:贰号token工厂
Codex、Claude Code、Trae、Qoder 要用的模型 token,统一接入、统一计费。
点这里看详情 →