


11 月 3 日晚上十点,做售后客服的老周被老板拉进群。老板甩上来一张账单截图:这个月输入费 504 块,上个月才 210。
老周翻后台,会话数一模一样,一天 500 次。变的是轮数。上个月产品提了个要求,让机器人"多问两句",平均一次会话从 4 轮拉到了 10 轮。
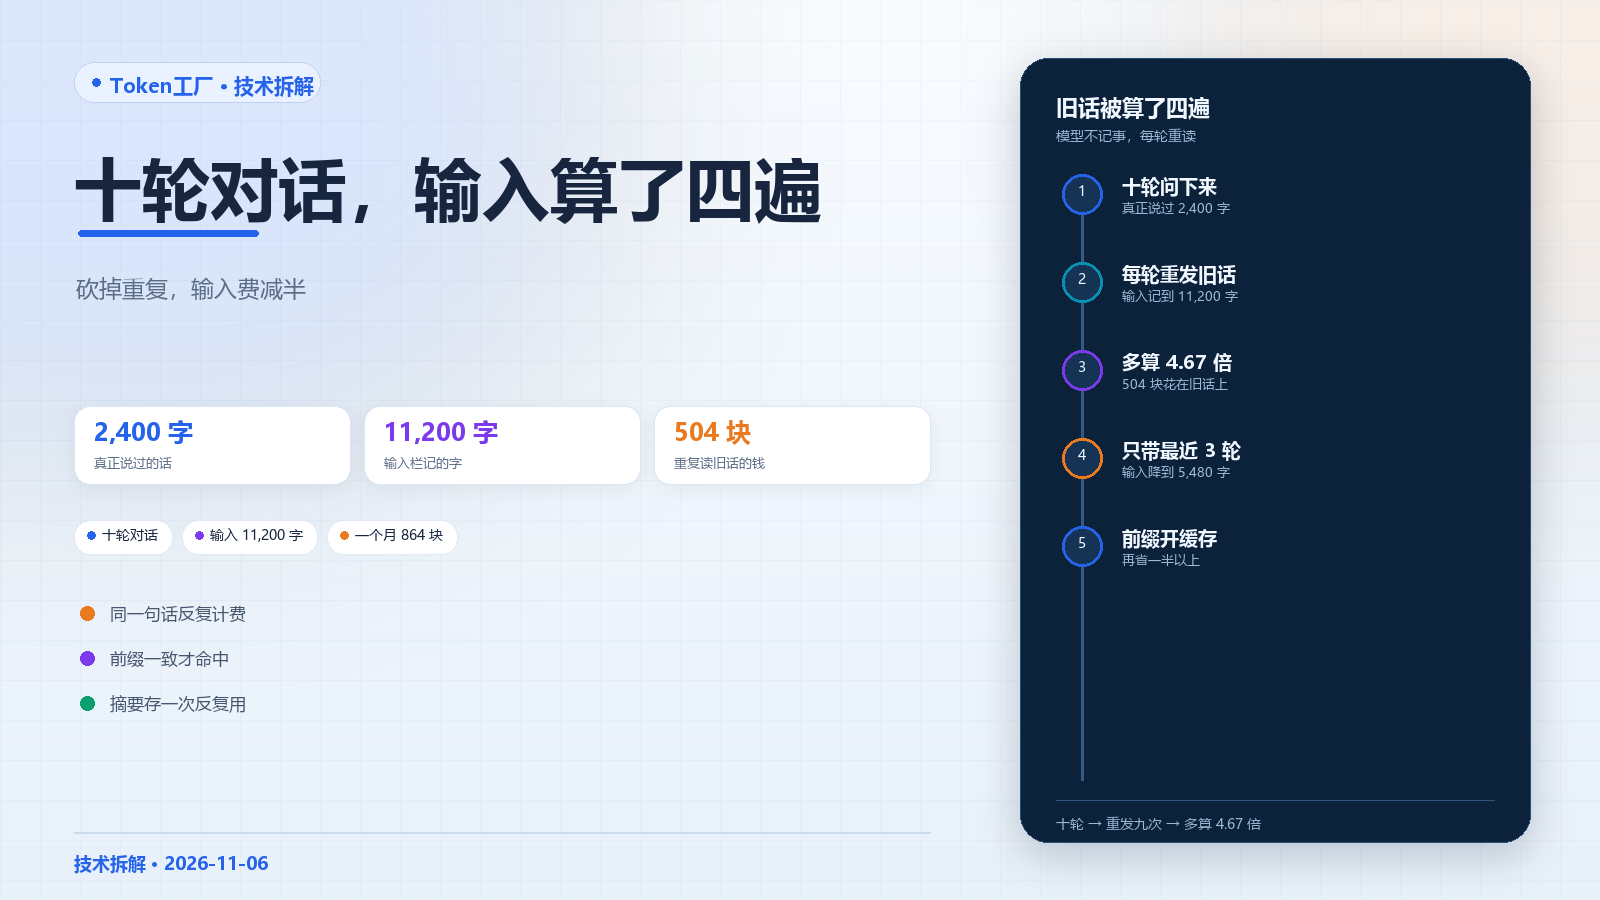
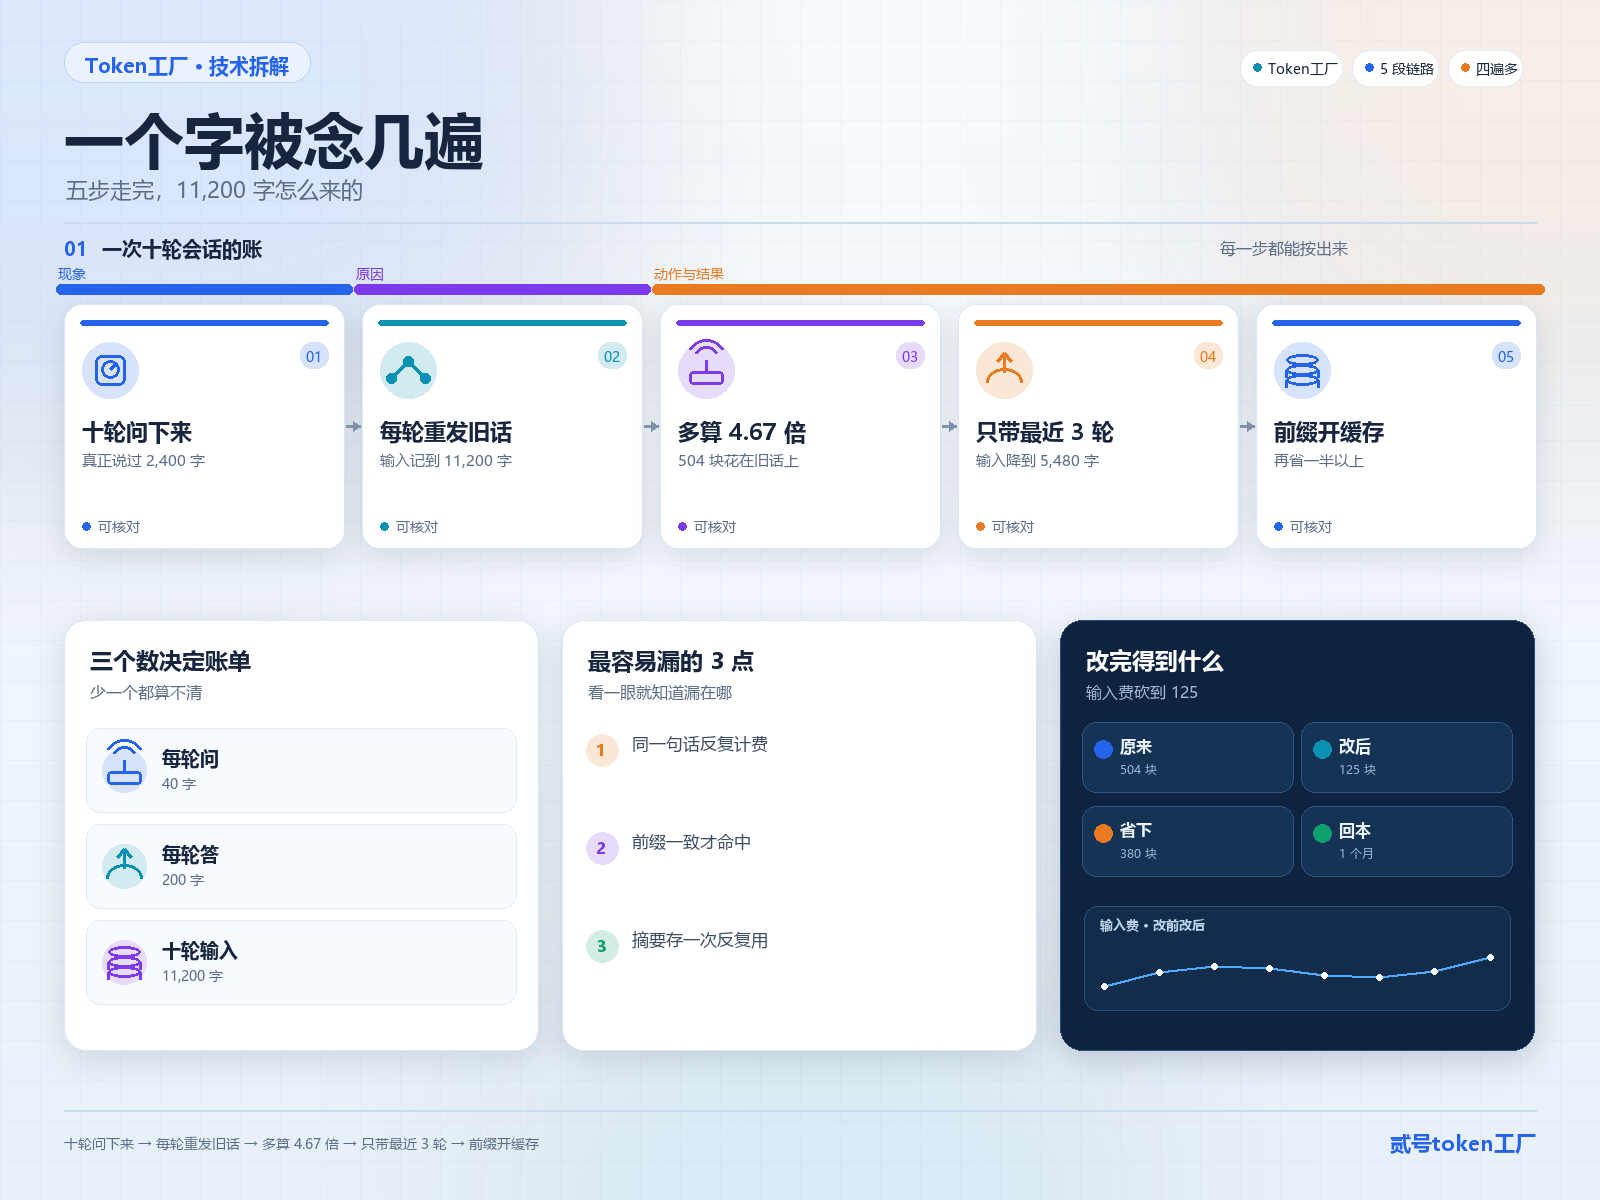
他把一次 10 轮的记录摊开数。用户每轮问 40 字,机器人每轮答 200 字,十轮加起来 2,400 字。账单的输入栏写的是 11,200 字。
同样的话,被算了四遍多。为什么?
为什么会这样
一句话:模型不记事。它每答一句,都得把前面所有的话重新读一遍,再收一次钱。
第 1 轮只发 40 字的问题,输入记 40 字。第 2 轮不行了,得把第 1 轮的问答一起发过去,40 加 200,240 字,再加新问题,输入 280 字。
第 3 轮 520 字,第 4 轮 760 字。每一轮都在上一轮的基础上再加 240 字。
到第 10 轮,前面 9 轮攒下 2,160 字,加上新问的 40 字,这一次输入就是 2,200 字。十轮加起来,11,200 字。他们真正说过的话只有 2,400 字,差 4.67 倍。
这个结构像年底给会计报账。不说"加上次那笔",而是每报一笔,就把从年初到现在的每一笔重念一遍。报到第 12 笔的时候,你已经念了 78 遍。
换算成钱更清楚。token 是模型切字用的最小单位,也是计费单位,一个汉字大约算 1.5 个。
11,200 字就是 16,800 个 token。假设输入 2 块一百万个 token,这一次会话的输入费是 3.4 分。
模型回的那 2,000 字是 3,000 个 token。输出通常更贵,假设 8 块一百万,2.4 分。
合起来不到 6 分,看着不多。一天 500 次,一个月就是 864 块,其中 504 块花在重复读旧话上。
怎么解决
三条办法,按改动从小到大排。
一,先把缓存打开。缓存就是平台把读过的内容存下来,下次直接取,不再算一遍钱。
这类平台的前缀缓存默认就开着,前缀就是从开头那个字开始的那一段,重发的部分按低价算。按官方口径,不做任何优化也平均省一半以上。
二,砍轮数。别把十轮全带上,只带最近 3 轮,前面加一句 100 字摘要。十轮的输入从 11,200 字降到 5,480 字,再省一半。
算法在纸上就能验:前 3 轮分别 140、380、620 字,之后每轮固定 620 字,十轮合计 5,480 字。
三,最后才上检索。把店铺规则、产品参数这些固定资料从提示词里搬出去,放进知识库,按问题只取 300 字。这条最贵,要建库、要调切片,一般两周。
别踩的三个坑。
一,摘要别每轮让模型现生成。生成一次就是一次调用,省下的钱又花回去。第 3 轮生成一次,存下来反复用。
二,别砍到只剩一轮。用户说"刚才那个",机器人就断片了。
三,别以为开了缓存就一定命中。前缀得从开头那个字起完全一样。有人在每轮前面加了个时间戳,折扣全没了。
平台怎么管这些问题
这类平台能接住的地方有六处,串起来是一条线。
一个地址接多个模型,base_url 换一处就行,base_url 就是代码里填的那个接口地址。在这个场景里,它让老周能把长会话先切到便宜的模型上试一遍,不行再换回来。
每次请求的输入和输出 token 分开记账。他正是靠这个查到"第 6 轮开始涨",而不是只看到一个总数。
前缀缓存。命中多少、没命中多少,账单上分两行写,谁都能对上。
会话策略。可以在平台侧统一设"只带最近 N 轮",或者超长自动摘要,客户端代码一行不改。
预算封顶和告警。日限额、月限额都能设,到了阈值发消息。
调用日志。每一笔带 API key,也就是调用时用的那串密钥,加上账号、时间和模型名,能倒查到是哪个人、哪个应用、哪一次请求。
后半段是人的事,四句话。
谁能改规则:技术负责人。轮数、限额、走哪个模型,最后是他签字。
谁能批减免:财务或者业务负责人。超额那部分要不要免,得有人认这个账。
出事能不能倒查到人:能。日志里有密钥和账号,谁调的、什么时候调的,一查就出来。
告警发给谁:值班的那个人,不是"技术群"。群里发一条,第二天没人记得。
这笔钱值不值
掏钱的是老板,一个月 864 块。钱不算多,但涨得没道理,所以他才追问。
先开缓存,不改代码,输入费按官方口径砍一半以上,504 块变 250 块左右。
再砍轮数,再省一半,输入费落到 125 块上下。两条加起来,一个月省 380 块。
回本也简单。前一条零成本,开通就生效;后一条一个人改半天。按一天 800 块的人工算,半天 400 块,一个月就回来了。
省下的钱不多。真省下的是那场会,不用再解释一遍"为什么字数会翻倍"。
行业规则怎么管这件事
这条线没有对口的国家政策,能查到原文的是平台的计费规则。
DeepSeek 在 2024 年 8 月 2 日的公告《DeepSeek API 创新采用硬盘缓存,价格再降一个数量级》里写得很直白:多轮对话中,每一轮都要将前几轮的内容重复输入。
同一份公告还定了一条硬规则:只有当两个请求的前缀从第 0 个 token 开始完全相同时,才算重复,从中间开始的重复不算。缓存命中的部分按 0.1 元一百万 token 收,存储不另收费。
规则落到老周身上是这样:那 11,200 字里,能被平台认成"重复"的,只有从开头那个字起就一模一样的那一段。中间多插一个时间戳,这 11,200 字一分折扣都拿不到。
老周最后没换模型,也没加预算。他把十轮砍到三轮,缓存一直开着。第二个月,输入费回到 210 块。
字数没变。变的是同一个字被念了几遍。
主流大模型 API token 统一接入、统一计费,改个地址就能用。