


昨天下午三点,测试前一天。手机号校验这块还空着,他懒得一个个工具试,就把同一句话在五个工具里各问了一遍:写个函数,校验手机号。
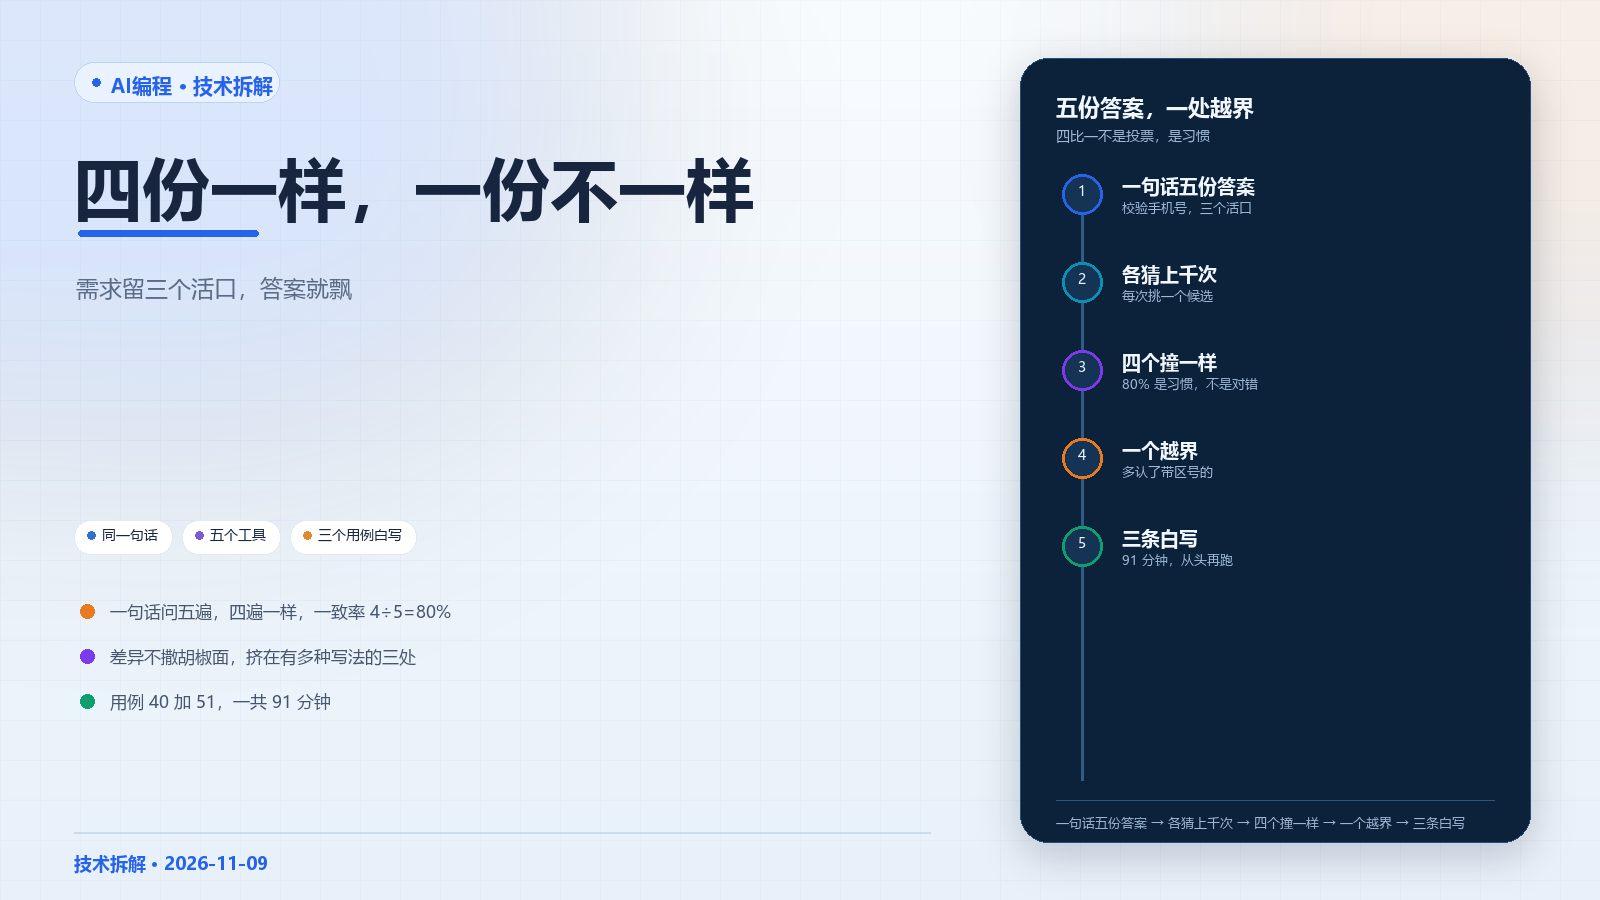
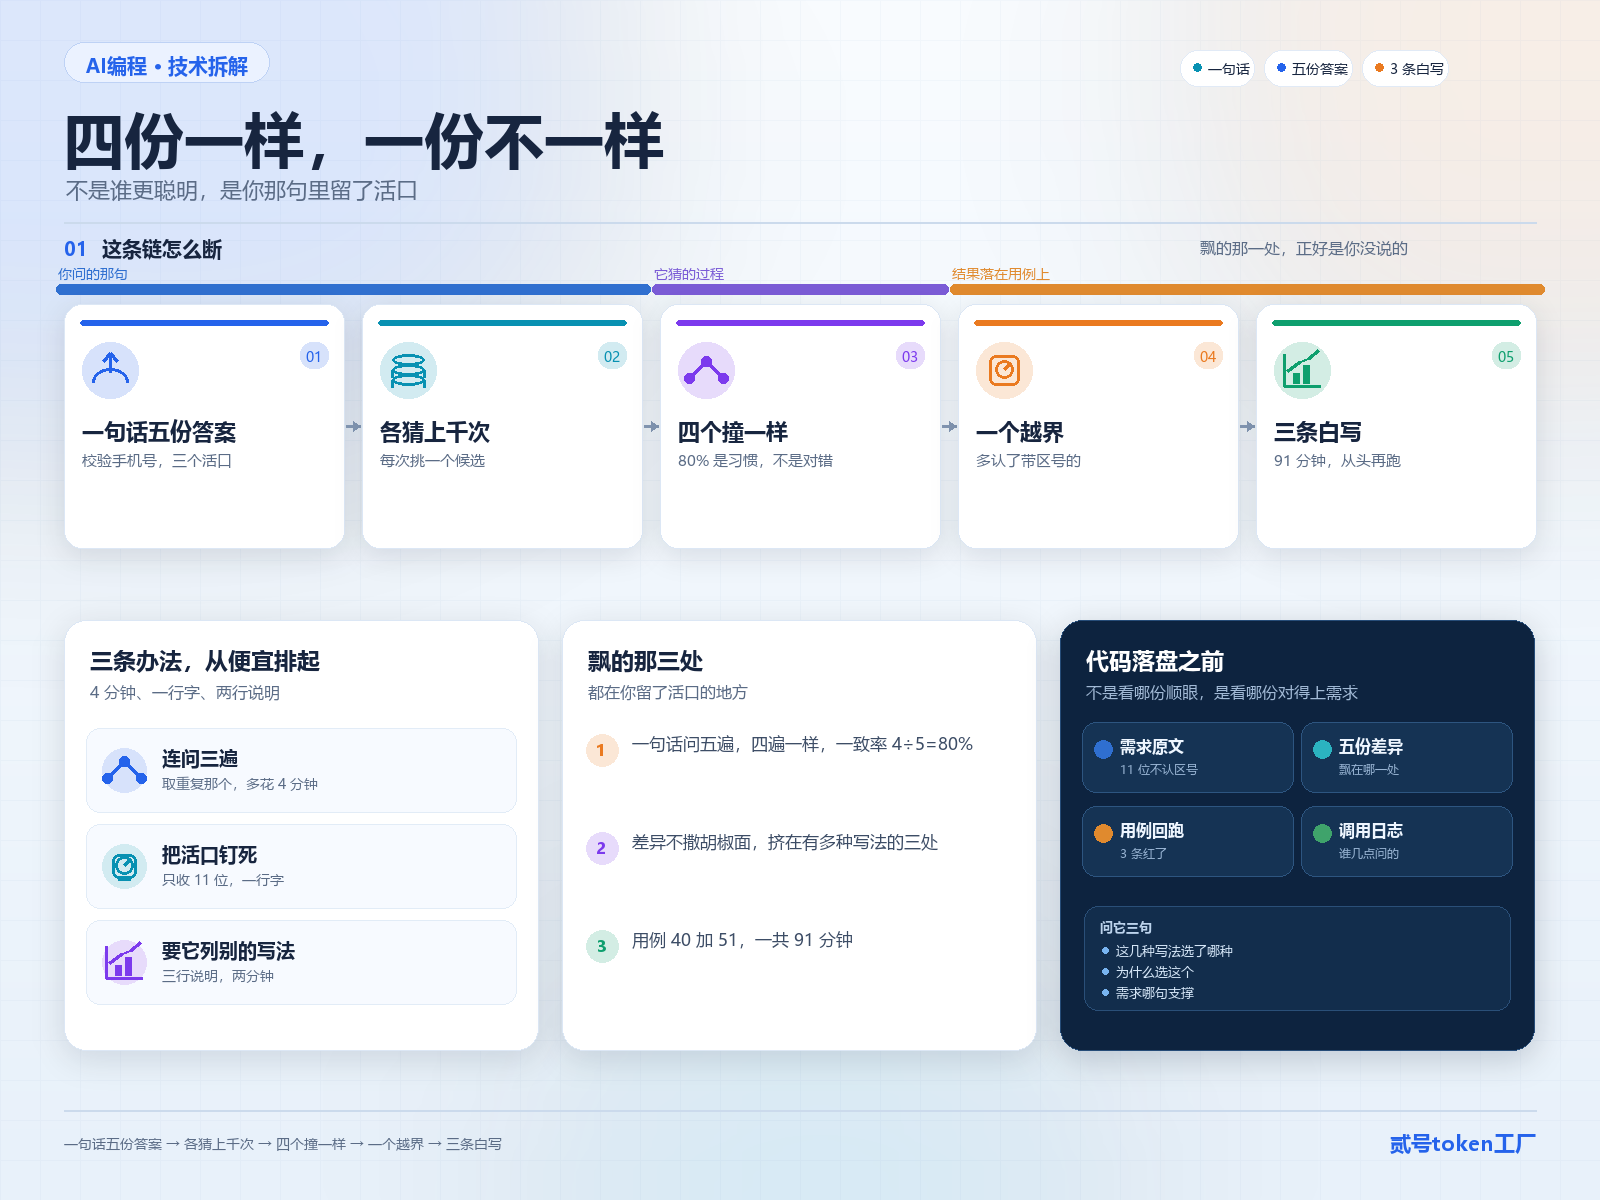
一句话,五个答案。四份一模一样:11 位数字,开头是 1,空格当没看见。第五份多认了一种,带 +86 的 13 位也放过。
他看那份多认了一种,觉得更周全,就用了它。第二天跑那 8 条用例,3 条红,因为需求写的是只收 11 位本地号。改回、重跑、重写用例花掉 91 分钟,他盯着那五行字看了半天,想不通:同一句话,五个工具,怎么会给出不一样的答案?
为什么会这样
它不是去资料库翻出一份标准答案,是一个字一个字往下猜。猜到岔路口,几个候选都说得通,它随手挑一个。
这段代码四十行,一千多个字符,它往下猜了上千次,每次从几个候选里挑一个。挑的时候带一点随机,所以同一句话问两遍,结果不保证一样。五份里四份相同,看着像稳,其实是 4÷5=80%,剩下那 20% 才是它的常态。
随机只在几种写法都说得通的地方起作用。校验手机号这五个字,里头有三个活口:要不要区号、要不要空格、要不要连座机。
换成把变量名 a 改成 b,只有一种写法,问五十遍也是五十遍一样。所以差异不是撒胡椒面,是挤在你留了活口的那几处。
换工具等于换一个猜法。五款工具背后接的模型不同,等于五个人默写同一段课文,字都写对了,可有人写"的"有人写"地"。四个一样只说明四个人习惯一样,不说明那四个对。
91 分钟这么来的:写 8 条用例 40 分钟,3 条白改 15 分钟,查为什么红 20 分钟,改回代码 10 分钟,重跑 6 分钟。
怎么解决
三条,从最便宜的开始。
同一句话连问三遍,取重复的那个。 成本是多问两遍,看一眼结果 4 分钟。改完差多少:那 51 分钟查红、改回、重跑的账,一开始就省了。
把活口钉死成一种。 在那句话后面补 12 个字:只收 11 位,不认区号不认空格,成本是一行字。改完差多少:三个活口降到零,五份答案会往一份收(收多少你那边得自己试)。
要它把别的写法列出来。 不只给代码,让它写三行:这件事有几种常见做法、你选了哪种、为什么。看那三行两分钟,比回头查 20 分钟便宜。
别踩三个坑。
拿"四比一"当投票。四份一样只说明四个习惯相同,不说明四份都对。
把一次结果抄进项目文档当标准答案。往后三次改动都跟着它错,账会滚。
以为换个工具就没有随机了。换了只是换了个猜法,你留的活口还在那儿。
平台怎么管这些问题
统一入口。 五款工具走同一个地址、一份密钥。在这个场景里,他不用为五个工具各配一遍,也不会因为某个没配好而少问一份。
随机旋钮定死。 控制随机大小的那个参数,一般叫温度,在入口统一设一个值。在这个场景里,五份飘的程度差不多,不会一个稳一个飞。
模型可选。 同一个入口换模型,代码不用改。在这个场景里,某种写法老飘,先换模型试,不用重装工具。
规则注入。 项目根目录那份"只收 11 位"的规矩,每次请求自动带上。在这个场景里,五份答案读到的是同一条。
请求日志。 每次调用留一条,带账号、时间、用了多少 token(token 是模型读写文字的计数单位,像手机流量,用多少算多少)。在这个场景里,事后能翻出那五遍分别是谁、几点问的。
用量归集。 按人、按项目出账。在这个场景里,五遍多花的钱能对到人头上。
这些功能平时谁管,四件事。
谁能改规则:那份"只收 11 位",只有测试负责人和开发负责人两个人能改,改完往群里贴两行改动。
谁能批减免:额度超了要加,走团队负责人一个人签字,不到处找人。
出事能不能倒查到人:每条调用带账号,先查那 90 分钟的日志,能指到具体的人和那句原话。
告警发给谁:发当天值班的那个人,名字写在值班表上,不发到一个群里。
这笔钱值不值
掏钱的是团队负责人,不是写代码的人。
91 分钟白干,按一小时 150 元估(假设),一次 227 元。一个月碰上三次,682 元。
快多少:三遍取一致多花 4 分钟,省下 51 分钟;那 12 个字写进需求模板,一次 10 分钟,往后每个需求都省。
多久回本:模板改一次 10 分钟,头一个需求就回来了。统一入口按用量算钱,他这个量级,一个月几十万 token 的账盖得住这 682 元。
行业规则怎么管这件事
这次对口的不是国家政策,是一份工程规矩:Reproducible Builds,中文叫可复现构建。Debian 社区 2013 年 7 月在 DebConf13 上发起,现在由独立项目组维护,官网上挂着定义。
定义的原话是:一套做法,让"从源码到二进制文件"这条路可以被别人独立验证。操作层面写得更直白:构建系统必须完全确定,给定同一份源码,永远产出同一个结果。
它要的效果是,同一份输入跑两遍,两个文件逐字节一样。所以你把软件下载下来,能自己重编一遍,再比两个文件,就知道有没有被人动过。
模型这边做不到。同一句话跑两遍不一样,这是它的工作方式,不是故障。
回到昨天下午那五行字。四份一样,可你没法像重跑构建那样验出哪份对,只能回头问需求。所以该钉死的不是工具,是那句话。
昨天下午那五分钟,他要的不是五份答案,是一句话里少留三个活口。需求钉死,五份就收成一份;需求松着,问五十遍也还是五份。这笔账不在工具上。
Token工厂:贰号token工厂
Codex、Claude Code、Trae、Qoder 要用的模型 token,统一接入、统一计费。
点这里看详情 →