


验收那天,八张卡全在跑,跑分数字很漂亮。三个月后业务上线,八张卡里只有三四张在真干活,剩下的就在那儿等着。
运维说不出哪里不对。采购单上写的是八张,老板问的是一天能出多少活,两个数对不上。
中间少了一步:没人算过一张卡到底能装下多少东西。
买卡的人看算力,用卡的人看显存。这两件事不在一个尺度上,卡就一半闲着。今天只讲一件事——为什么算力按卡算,一张卡能干什么。
一句话原理
一张 GPU 卡能干多少活,先看显存能装下多少,再看算力能算多快。显存装不下,算力再强也开不了工。
所以卡不能拆开卖。显存、算力、卡与卡之间的通路,是一整套东西,只能按张计价、按张排队。
一个具体例子
假设一个机房有八张卡,每张 80GB 显存。这就是一台很常见的八卡机。
先看一个大模型。700 亿参数的模型,用半精度存下来,光权重就要约 140GB。一张卡装不下,至少得切成两张跑。
切开了就得配合。两张卡每一步都要交换中间结果,来回搬数据,速度就掉下来一截。
再看一个小模型。70 亿参数,半精度约 14GB。加上中间结果和几路并发请求的缓存,一张卡能同时服务好几路。
同样一张卡,装大模型时只够分工,装小模型时能顶好几路。这就是"一张卡能干什么"没有固定答案的原因。
还有一种常见情况。一张卡里同时塞两个小任务,每个都要先占一块显存留着,加起来超了,就有一个被挤掉重跑。
换个说法。一张卡像一个厨房操作台:台面就是显存,刀工就是算力。
台面决定能摊开多少菜,刀工决定切多快。台面只摊得下半只羊,刀再快也得先把另一半塞进冰箱,来回取就是卡之间的通信。
一个小闭环
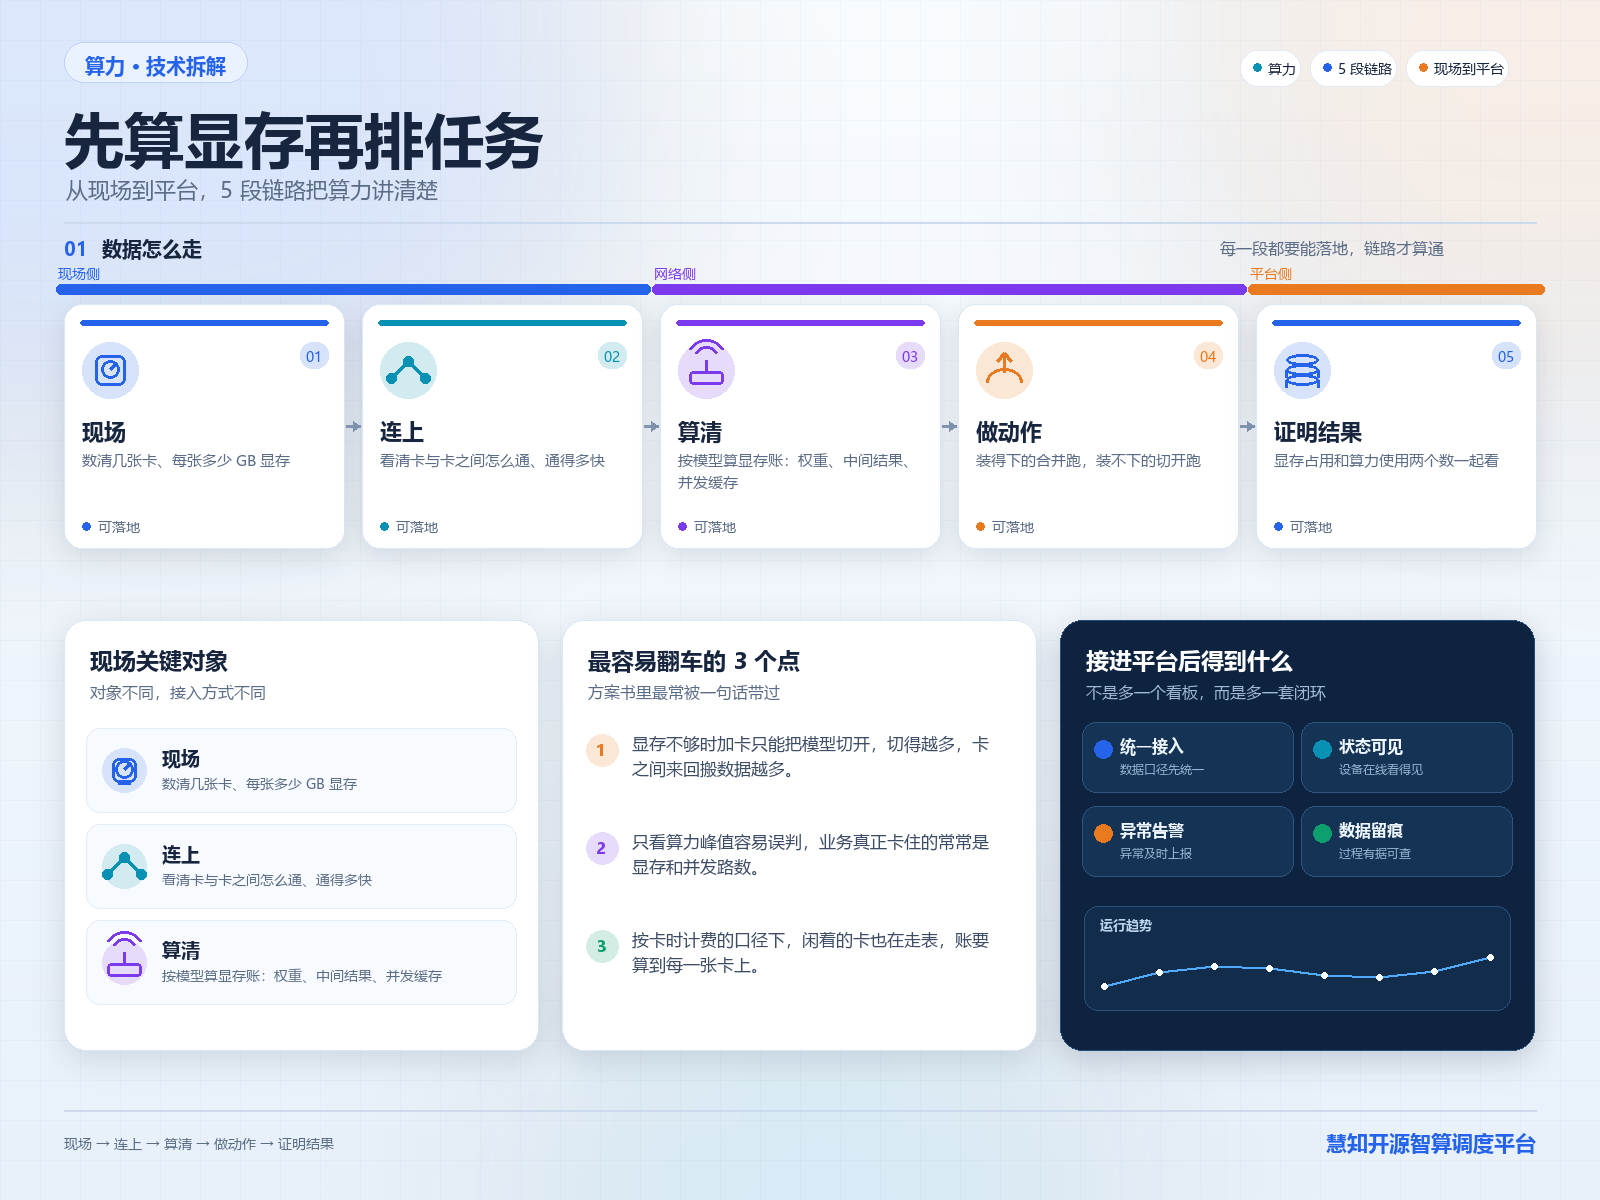
- 现场。 输入是采购单和设备清单,动作是数清几张卡、每张多少 GB,输出一张卡表。少了这步,后面只能按机器台数拍脑袋。
- 连上。 输入是卡表,动作是看清卡与卡之间怎么通、通得多快,输出一张能查的通路图。少了这步,切开跑的模型会慢得莫名其妙,还找不到原因。
- 算清。 输入是模型大小和并发目标,动作是按权重、中间结果、并发缓存这三笔算显存,输出一张单卡容量表。少了这步,排任务只能靠一次次试。
- 做动作。 输入是容量表,动作是装得下的合并跑、装不下的切开跑,输出排好的任务。少了这步,大任务占满整卡,小任务在外面排队。
- 证明结果。 输入是排好的任务,动作是同时看显存占用和算力使用两个数,输出下一轮的调整依据。少了这步,闲着的卡会一直闲着。
三条技术确认点
一,确认单卡显存多大、卡间怎么连。显存定的是上限,通路定的是切开之后掉多少速度,两条都得问。
二,确认模型真实占多少显存。不能只按参数量乘二估,中间结果和并发缓存经常占掉一大块,估少了上线就爆。
三,确认按什么计量。按卡时算,闲着的卡也在走表;按显存占用或实际算力算,同一批卡出来的账完全不同。
常见误区
看起来是卡越多越快,其实是显存不够的时候,加卡只是把模型切得更碎,卡之间搬数据的量跟着往上涨。
看起来是跑分高就够用,其实是跑分测的是峰值,真实业务往往卡在显存和并发路数上,跟峰值关系不大。
看起来是照卡数买最省,其实是按显存需求配比,大卡配小卡混着买,总钱数常常更低。
回到开头
八张卡一半闲着,不是卡不好,是没人算过每张卡能装多少。
先数清显存,再按容量排任务,同一批卡能多干活。算力按卡算,账就得算到每一张卡上。
GPU 资源池化、任务调度、多租户和计费一套管,装在自己服务器上,能改能扩。